
Entre los ojos en blanco, los hombros encogidos, las manos vibrantes y la inflexión vocal gorjeante, no es difícil saber cuándo alguien está siendo sarcástico mientras te está dando el negocio cara a cara. En línea, sin embargo, necesitará ese meme de Bob Esponja y una aplicación liberal de la tecla de mayúsculas para hacer entender su punto contradictorio. Por suerte para nosotros los internautas, Oficina de Innovación de la Información de DARPA (I2O) ha colaborado con investigadores de la Universidad de Florida Central para desarrollar una inteligencia artificial de aprendizaje profundo capaz de comprender el sarcasmo escrito con un grado sorprendente de precisión.
«Con la alta velocidad y el volumen de datos de las redes sociales, las empresas confían en herramientas para analizar datos y brindar servicio al cliente. Estas herramientas realizan tareas como administración de contenido, análisis de sentimientos y extracción de mensajes relevantes para que los representantes de servicio al cliente de la compañía respondan «, dijo a … por correo electrónico el profesor asociado de Ingeniería Industrial y Sistemas de Gestión de la UCF, Dr. Ivan Garibay. «Sin embargo, estas herramientas carecen de la sofisticación para descifrar formas de lenguaje más matizadas como el sarcasmo o el humor, en las que el significado de un mensaje no siempre es obvio y explícito. Esto impone una carga extra al equipo de redes sociales, que ya está inundado con los mensajes de los clientes para identificar estos mensajes y responder adecuadamente «.
Como explican en un estudio publicado en la revista, Entropía, Garibay y la estudiante de doctorado de UCF, Ramya Akula, han construido “un modelo de aprendizaje profundo interpretable utilizando auto-atención de múltiples cabezas y unidades recurrentes cerradas. El módulo de auto-atención de múltiples cabezas ayuda a identificar palabras clave sarcásticas cruciales a partir de la entrada, y las unidades recurrentes aprenden dependencias de largo alcance entre estas palabras clave para clasificar mejor el texto de entrada «.
«Básicamente, el enfoque de los investigadores se centra en descubrir patrones en el texto que indiquen sarcasmo», dijo el Dr. Brian Kettler, gerente de programa en I2O que supervisa el Programa SocialSim, explicado en un comunicado de prensa reciente. «Identifica palabras clave y su relación con otras palabras que son representativas de expresiones o declaraciones sarcásticas».
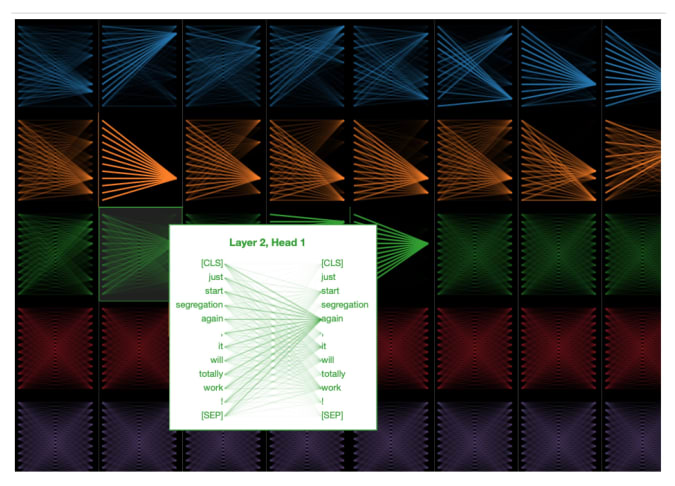
La metodología del equipo se diferencia de enfoques utilizados en esfuerzos previos usar máquinas para detectar Sarcasmo de twitter. «La forma más antigua de abordarlo sería sentarse allí y definir las características que veremos», dijo Kettler a …, «tal vez, las teorías de los lingüistas sobre lo que hace que el lenguaje sea sarcástico» o los marcadores de etiquetado extraídos del contexto de la oración, como un Revisión aleatoria positiva de Amazon sobre un producto o característica que de otro modo sería universal. El modelo también aprendió a prestar atención a palabras y puntuación específicas como simplemente, nuevamente, totalmente y «!» una vez que los notó. “Estas son las palabras de la oración que insinúan sarcasmo y, como era de esperar, reciben más atención que otras”, escribieron los investigadores.

Laboratorio de sistemas adaptativos complejos, Universidad de Florida Central
Para este proyecto, los investigadores utilizaron un grupo diverso de conjuntos de datos procedentes de Twitter, Reddit, The Onion, Huffpost y los diálogos Sarcasm Corpus V2 de la Corpus de argumentos de Internet. “Esa es la belleza de este enfoque, todo lo que necesita son ejemplos de capacitación”, dijo Kettler. «Suficiente de esos, y el sistema aprenderá qué características en el texto de entrada predicen que el lenguaje es sarcástico».
Este modelo también ofrece un grado de transparencia en su proceso de toma de decisiones que normalmente no se ve en modelos de inteligencia artificial de aprendizaje profundo como estos. La IA del sarcasmo en realidad mostrará a los usuarios qué características lingüísticas aprendió y pensó que eran importantes en una oración determinada a través de las visualizaciones de su mecanismo de atención (abajo)
Laboratorio de sistemas adaptativos complejos, Universidad de Florida Central
Aún más impresionante es la exactitud y precisión del sistema. En el conjunto de datos de Twitter, el modelo registró una Puntuación F1 de 98,7 (8,7 puntos más que su rival más cercano) mientras que, en el conjunto de datos de Reddit, obtuvo 81,0 – 4 puntos más que la competencia. En los titulares, obtuvo una puntuación de 91,8, más de cinco puntos por delante de sistemas de detección similares, aunque pareció tener problemas con los Diálogos (solo alcanzó un F1 de 77,2).
A medida que el modelo se desarrolle más, podría convertirse en una herramienta invaluable tanto para el sector público como para el privado. Kettler considera que esta IA encaja en la misión más amplia del programa SocialSim. «Es una parte de lo que estamos haciendo de manera más amplia, que realmente es observar y comprender el entorno de información en línea», dijo, tratando de averiguar «el compromiso a un alto nivel [and] cuántas personas es probable que interactúen con qué tipo de información «.
Por ejemplo, cuando los NIH o los CDC llevan a cabo una campaña de salud pública y solicitan comentarios en línea, a los organizadores les resultará más fácil evaluar la opinión general del público sobre la campaña después de que se hayan filtrado las respuestas sarcásticas de los trolls y los fanáticos de la mierda.
«Nos gustaría entender el sentimiento», continuó. «Cuando las personas son atractivas, a las personas les gusta algo o no les gusta algo, y el sarcasmo puede engañar a la detección de sentimientos … Es una tecnología importante y permite que la máquina interprete mejor lo que estamos viendo en línea».
El equipo de UCF tiene planes de desarrollar aún más el modelo para que pueda usarse en otros idiomas además del inglés antes de que finalmente se abra el código. Sin embargo, Garibay señala que un posible punto de fricción será su capacidad para generar «conjuntos de datos voluminosos de alta calidad en varios idiomas. Entonces, el próximo gran desafío sería manejar las ambigüedades, los coloquialismos, la jerga y hacer frente a la evolución del lenguaje».
Todos los productos recomendados por … son seleccionados por nuestro equipo editorial, independiente de nuestra empresa matriz. Algunas de nuestras historias incluyen enlaces de afiliados. Si compra algo a través de uno de estos enlaces, es posible que ganemos una comisión de afiliado.